Nota de investigación
Desmontando una red de 32 números
También publicado en el EA Forum.
1. Contexto de Leeuwenhoek.
He decidido llamar al proyecto Leeuwenhoek, un pionero de la microscopia que identifico en una sola gota de agua miles de seres diminutos, “animaculos”. Nuestros animaculos son redes neuronales.
ARC (Alignment Research Center, un laboratorio de seguridad de IA), publico una serie de redes minusculas que iban desde los 8 a los 1408 parametros, “diminutas” en comparacion a los modelos que tenemos hoy en dia. Estas redes habian sido entrenadas para cosas muy basicas como encontrar el segundo numero mas grande o la mediana. Ellos piensan que si no somos capaces de entender redes tan pequeñas como vamos a entender las de miles de millones. Tiene sentido si te paras a pensarlo y plantean un reto muy interesante.
Cuando estuve revisando sus avances y las participaciones vi que mucha gente se centraba en una familia de AlgZoo, 2nd_argmax (ARC ya entiende mas o menos su red de 32 parametros, que no es esta), y que, por lo que he podido encontrar (noviembre de 2026), argmedian estaba sin explicar en publico, entonces, aqui estamos.
2. Qué hace
La red recibe 3 numeros, (x1, x2, x3) y entre ellos busca la mediana. Es una red neuronal recurrente, es decir, lee los 3 numeros de uno en uno y guarda lo necesario en 4 neuronas. Tiene en total 32 parametros y acierta el 98,46% de las veces. Vamos a responder 2 preguntas, como lo hace con tan solo 4 neuronas y porque falla un 1,54%, no porque acierta un 98, nos importa ver donde falla y porque.
3. Dónde falla
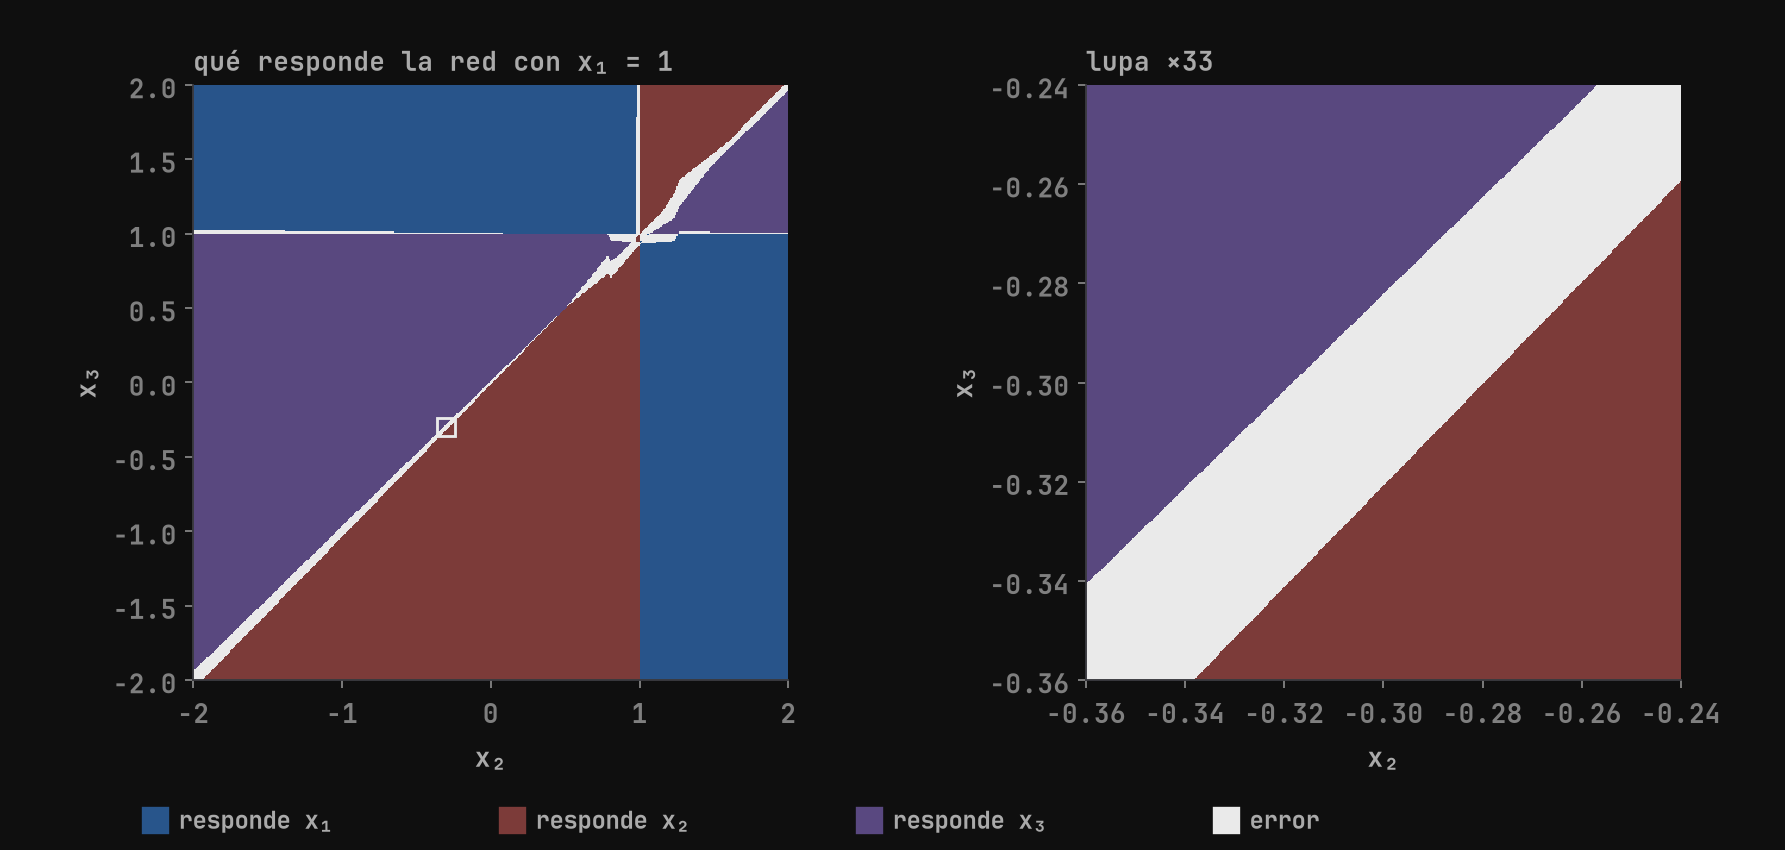
Lo primero que note fue que la red no tiene sesgos, es decir, si multiplicamos todos los numeros por igual las neuronas y las puntuaciones de salida se multiplican por dicho numero pero la respuesta no cambia. Dos conjuntos de numeros proporcionales, como (1, 2, 3) y (2, 4, 6), obtienen la misma respuesta. Esto nos hace ver que realmente solo le importa la direccion del vector, no su longitud. Ahora, como las entradas son gaussianas sabemos que todas las direcciones son igual de probables, esto, a su vez, hace que el hacierto de la red sea un porcentaje de la superficie de una esfera. Asi que la planteamos asignando colores a cada punto y marcando en blanco los errores.
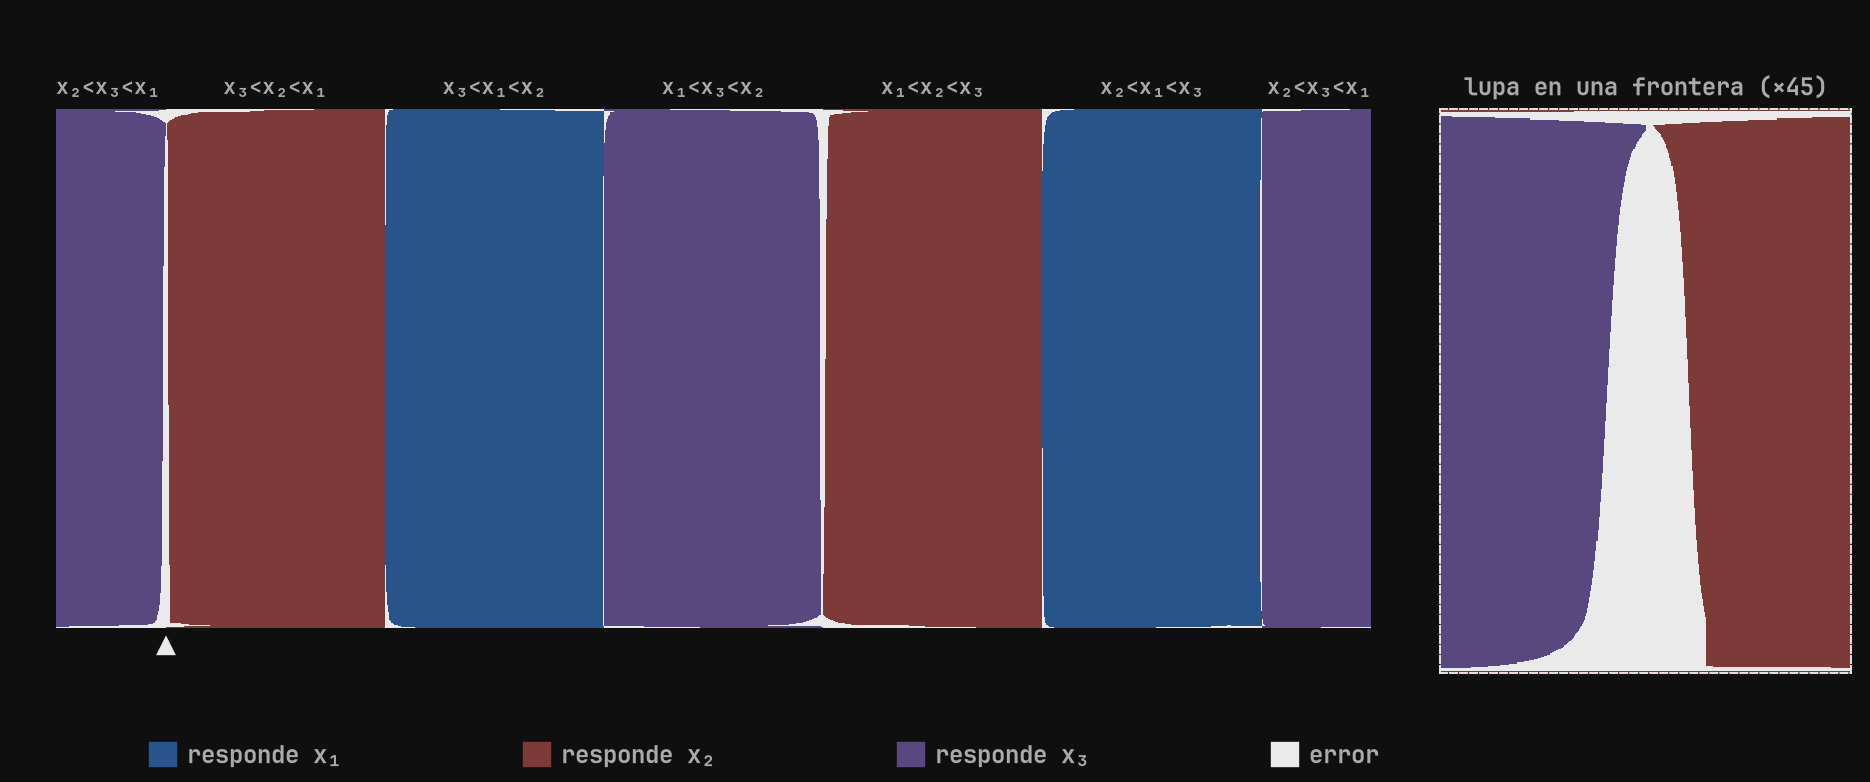
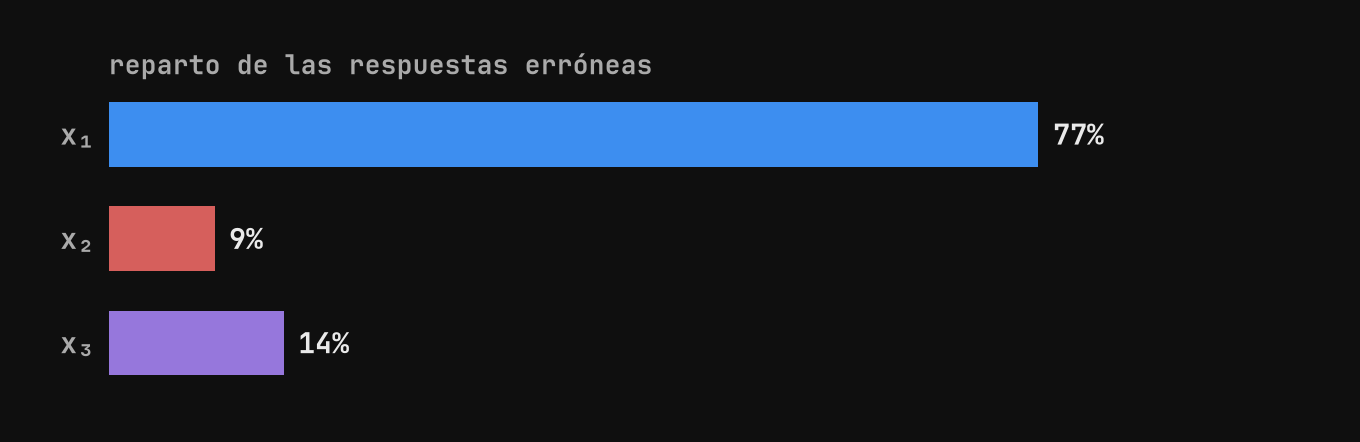
Gracias a esto observamos que los errores eran lineas muy finas que coincidian casi con exactitud a las fronteras donde dos numeros empataban. Es decir, la red parece solo equivocarse cuando dos numeros son casi iguales. Luego vimos que un 77% de las respuestas erroneas tendian a x1, por algun motivo la red tiraba hacia la posicion de x1.
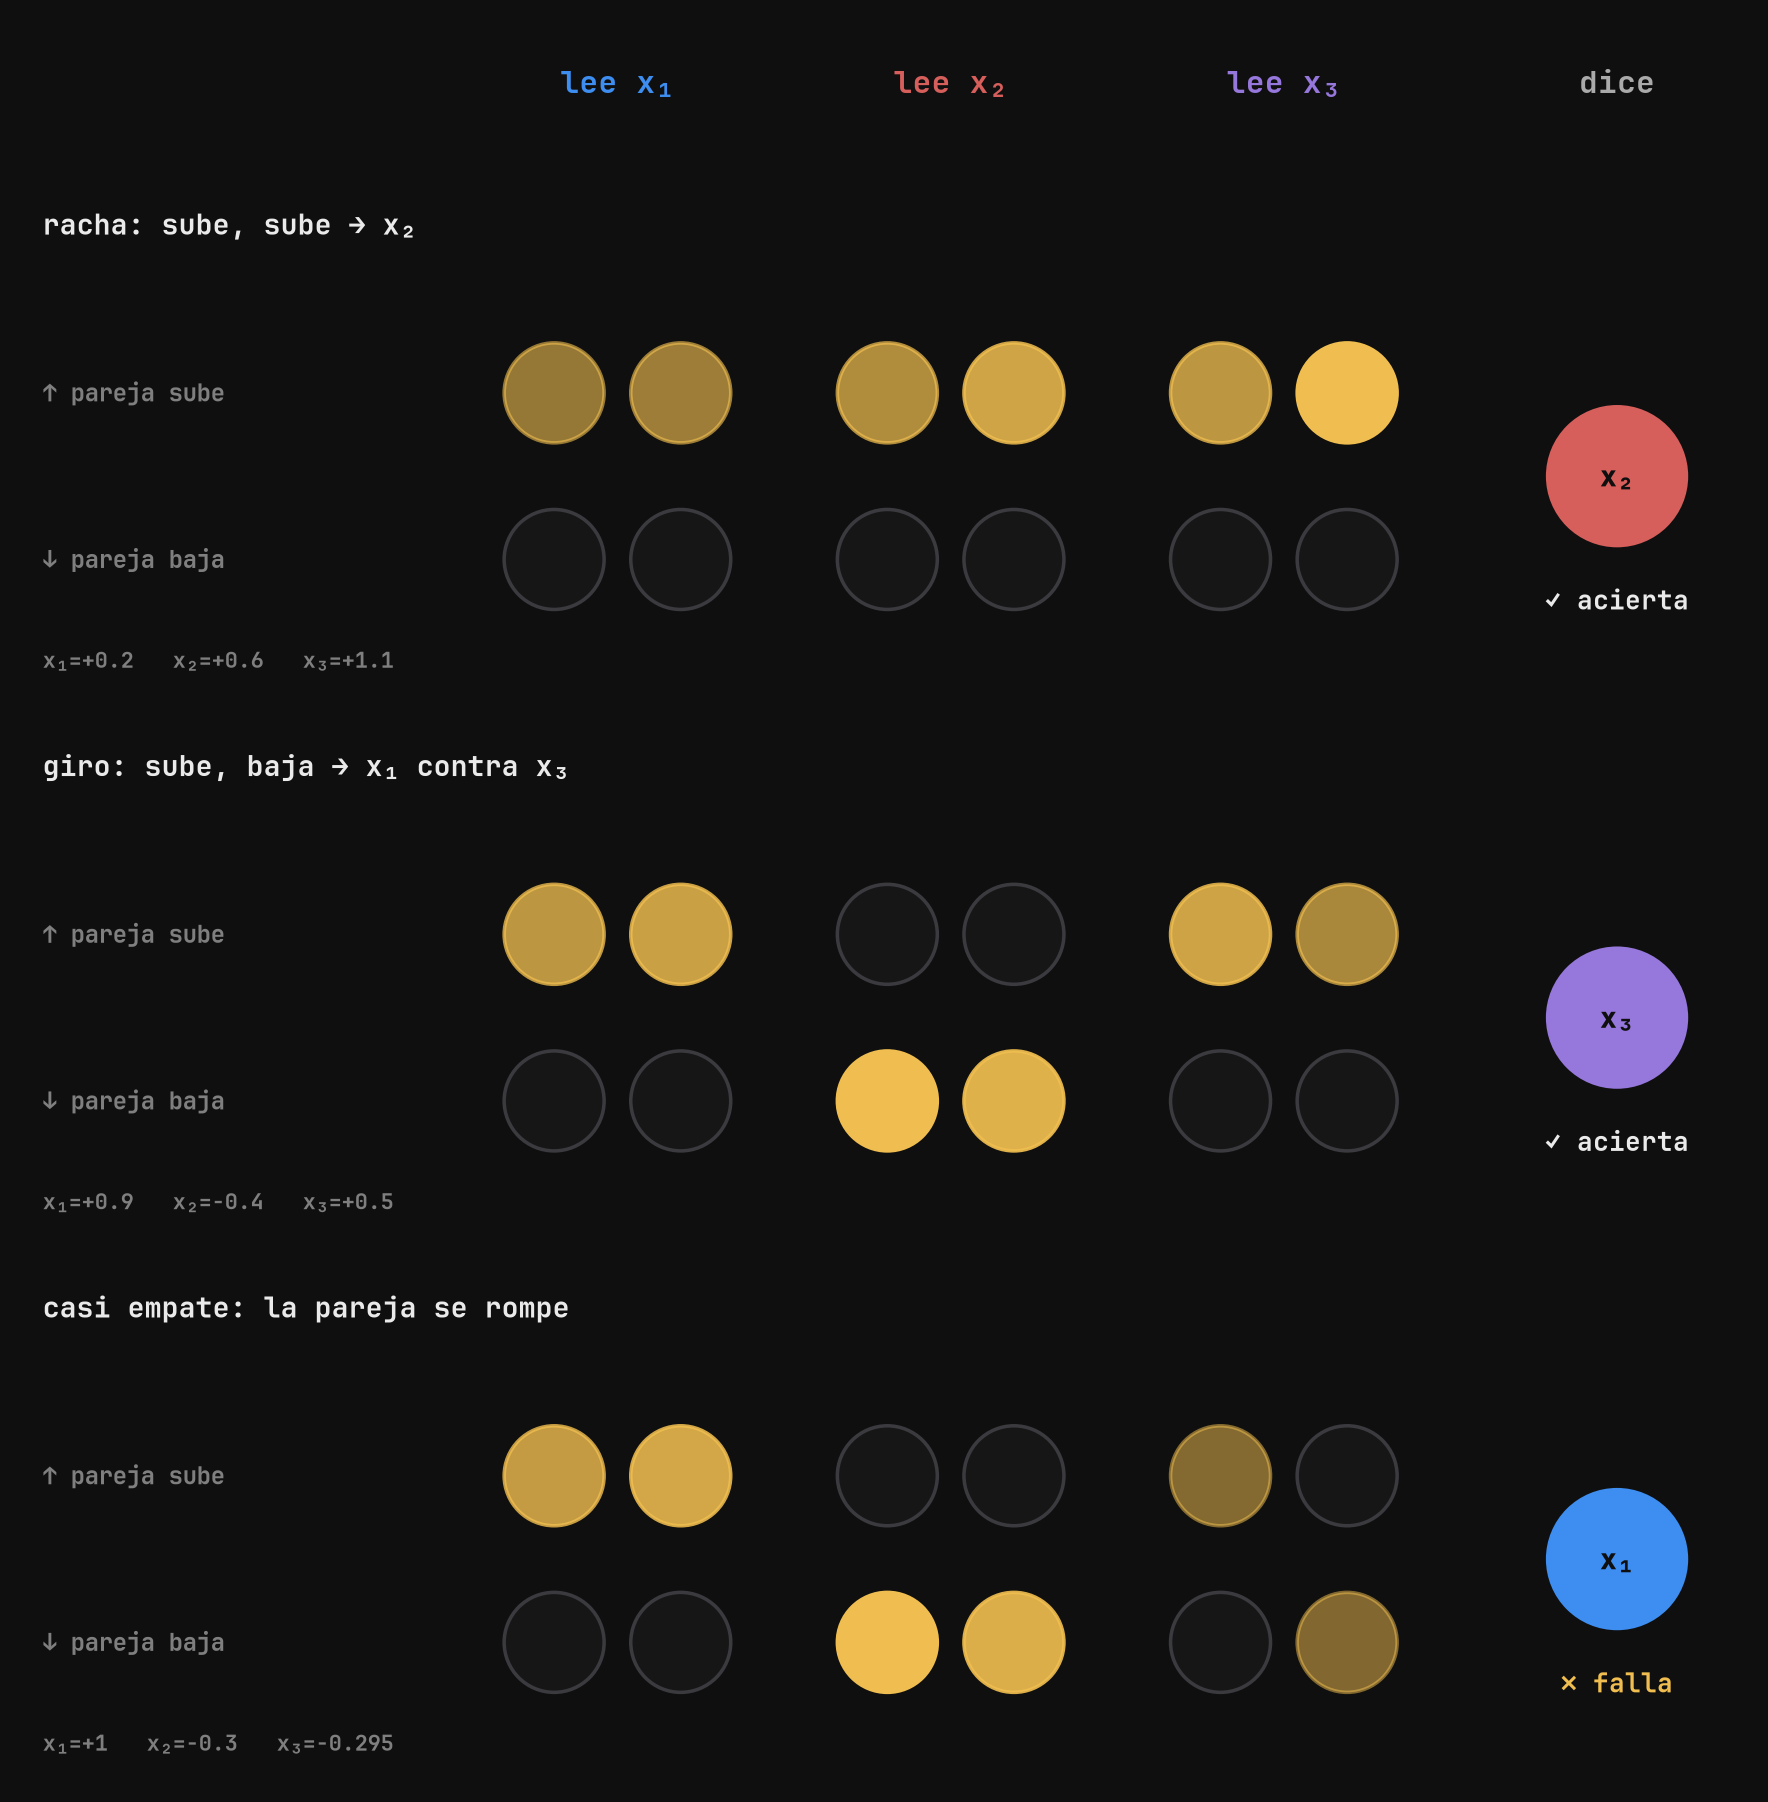
Despues observamos como reaccionan las neuronas viendo cuales se encienden en cada paso, observando vimos que las 4 neuronas resultaron ser dos parejas espejo. Que quiere decir esto: una pareja se enciende cuando el numero ha subido respecto al paso anterior y la otra se enciende cuando baja. Al tener 3 entradas la red evalua en 3 subidas o bajadas (en la primera compara x1 con 0, asi que las que importan son las dos ultimas), esto nos deja con una idea muy clara de como es la estrategia de la red. Cuando sube en el paso 2 y vuelve a subir en el 3 o viceversa (baja y baja), sabemos que la mediana es x2, siempre. Pero cuando es alterno, es decir, sube primero y luego baja o al reves, x2 se vuelve un extremo y la red compara x1 con x3.
Aqui nos topamos con un problema, la red debe acordarse de x2 si quiere evaluar si x3 sube respecto a x2, pero solo tiene 4 neuronas y en cada paso se enciende una pareja. La pareja lleva 2 canales y si en lugar de mirar una neurona y luego otra mirasemos la suma y su diferencia nos damos cuenta de que la suma es el canal de comparacion, con este sacamos su signo que nos dice si subio o bajo. La diferencia es el canal de memoria, mucho mas pequeña que el de comparacion y con ella la red recontruye el numero anterior que necesita para la siguiente comparacion.
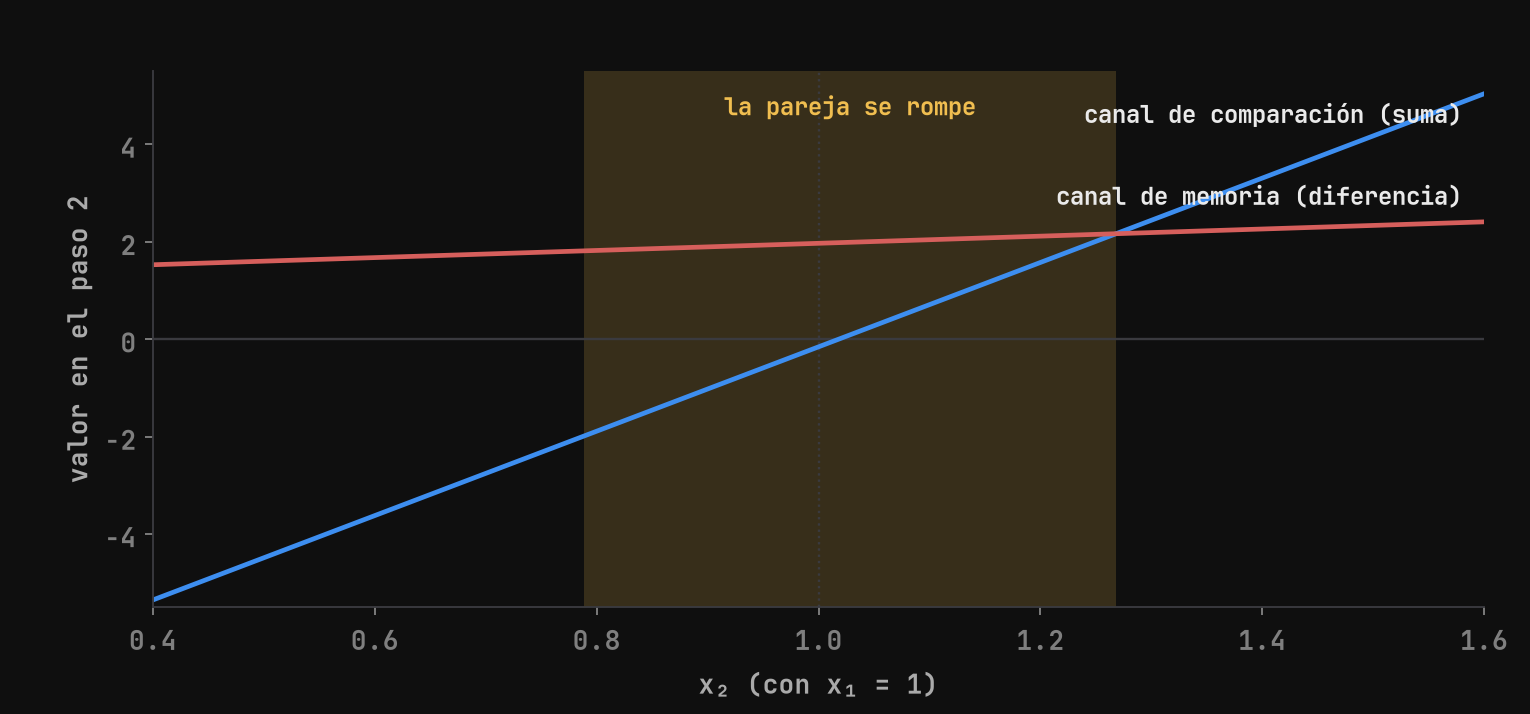
Sabiendo esto volvemos al problema de los empates y es que cuando dos numeros son casi iguales, la comparacion (el primer canal) se queda casi a cero y al ser mas pequeña que el canal de la memoria la pareja de neuronas se rompe y se quedan encendidas una neurona de cada pareja como si la red dudase, o directamente se apagan todas. Cuando hay un empate la red tiende a escoger la primera posicion, x1, por eso la red tiende a equivocarse mas hacia x1.
4. La vuelta
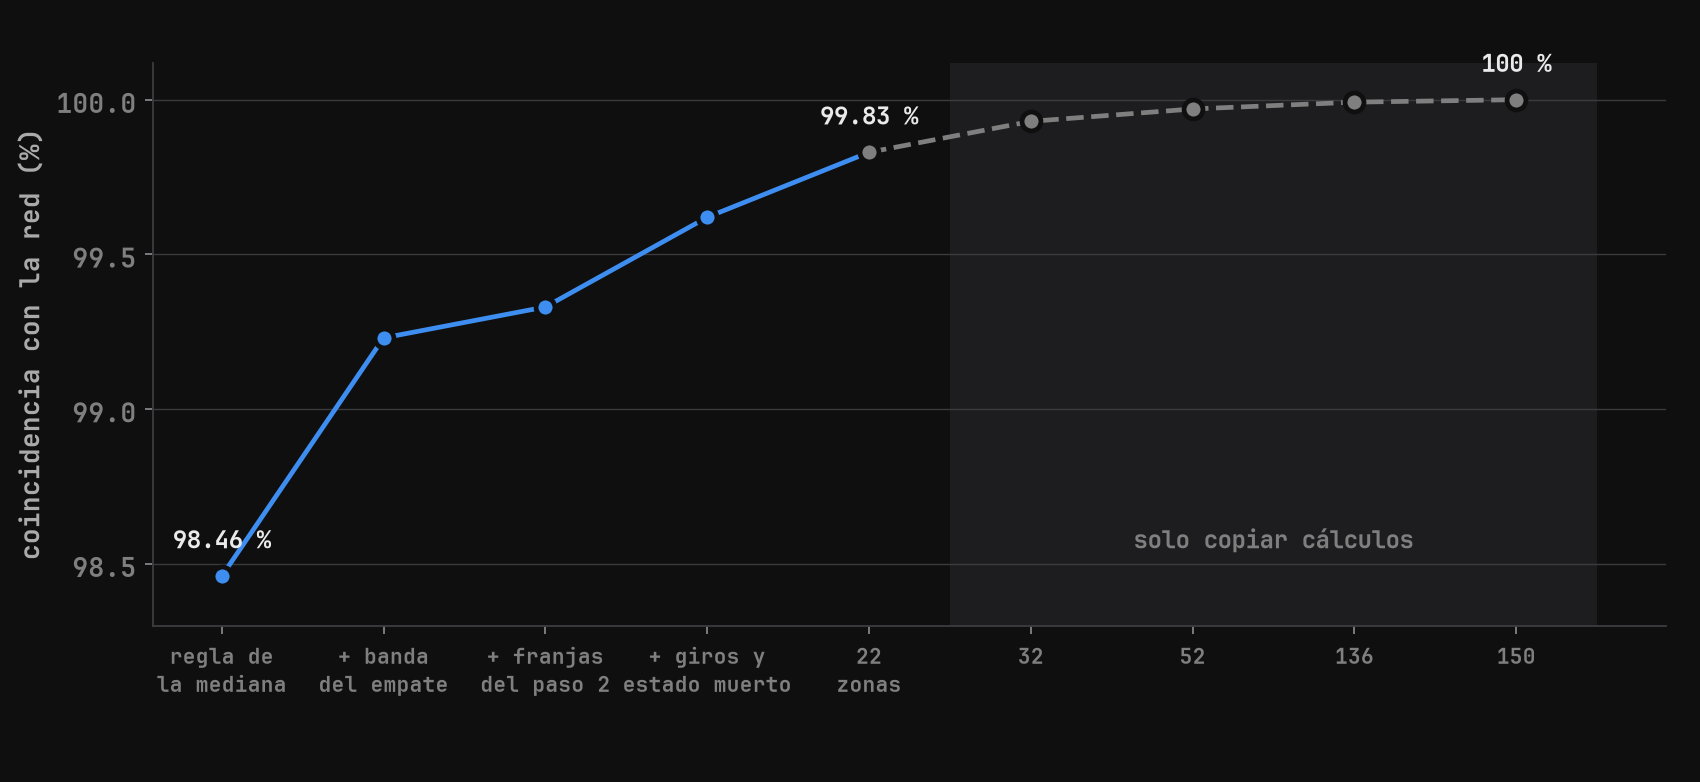
Una explicacion solo la doy por valida si con ella puedo fabrican un gemelo que haga exactamente lo mismo que la red. El primer gemelo fue la primera estrategia de la que hablamos. Coincidia con la red en un 98,46% de las entradas que es exactamente su acierto, logico ya que esa regla es la mediana perfecta asi que solo coincide justo donde la red acierta. Para explicar los errores fuimos añadiendo las zonas donde la red fallaba, cada una sacada de sus pesos. La banda del empate, las fronteras desplazadas y donde todo se apagaba. La coincidencia fue de 98,82% y poco a poco llego a un 99,83% con 22 zonas. Empujamos un poco mas y con 150 zonas llegamos al 100%, coincidiendo con la red en 4.000.000 de entradas, pero siendo sincero esto fue copiar calculos y no nos aportaba nada, nos centramos en las 22 zonas.
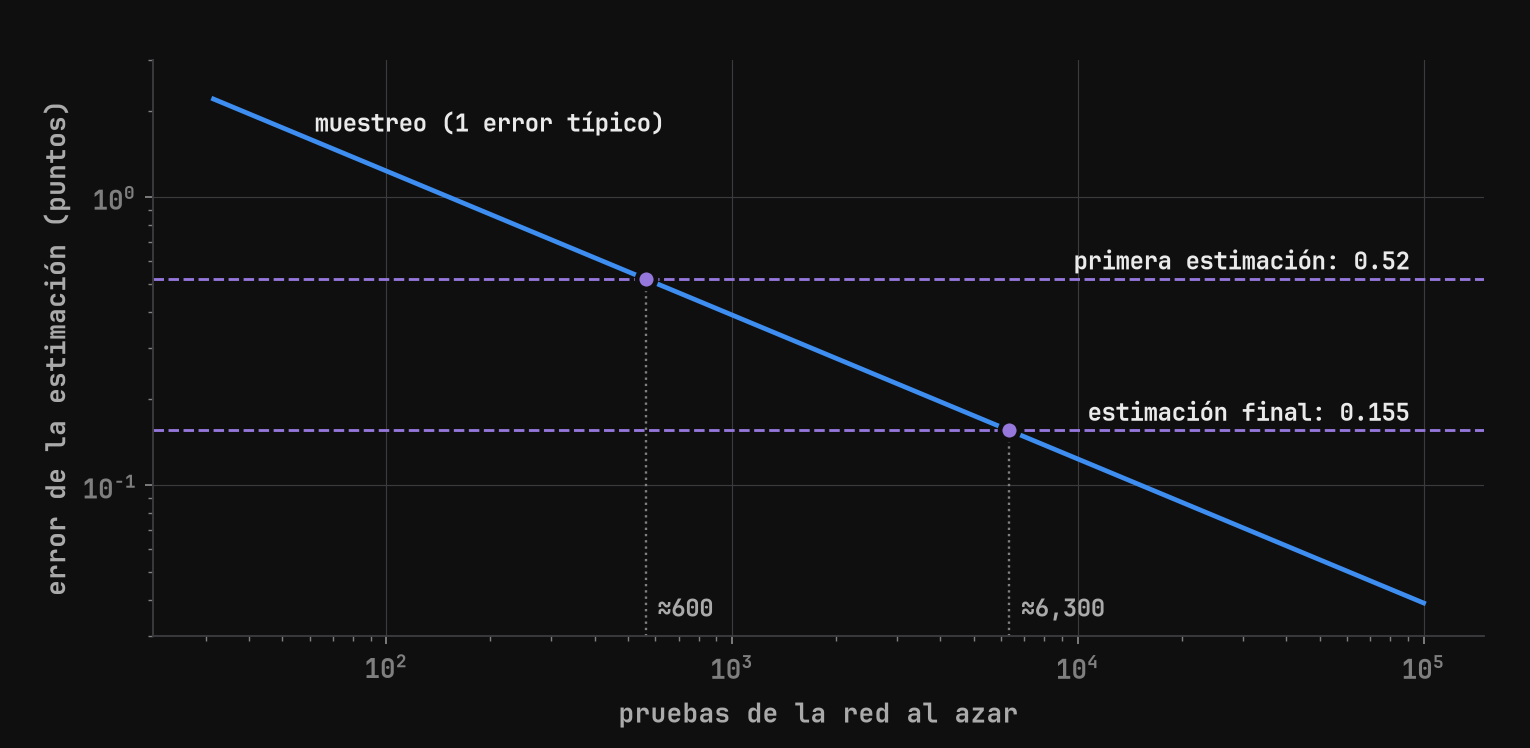
Despues pasamos a la metrica de ARC. Sacamos el acierto exacto de la red sin probarla ni una vez, dentro de cada combinacion de neuronas encendidas la red solo suma y multiplica asi que lo que hicimos fue recorrer las 70 combinaciones posibles y sumamos el area de cada trozo de esfera, esto nos dio un 98,455038%. El resultado fue a fuerza brunta y lo hicimos asi para sacar la cifra exacta con la que medirnos. Luego estimamos el acierto fijandonos solo en el error que habiamos explicado sumando el area de dichas zonas. La primera estimacion se nos quedo a 0,52 puntos del exacto y la ultima a 0,15. Si lo calculamos nos sale que necesitariamos mas o menos 6300 pruebas de la red si queremos conseguir la misma precision probandola al azar.
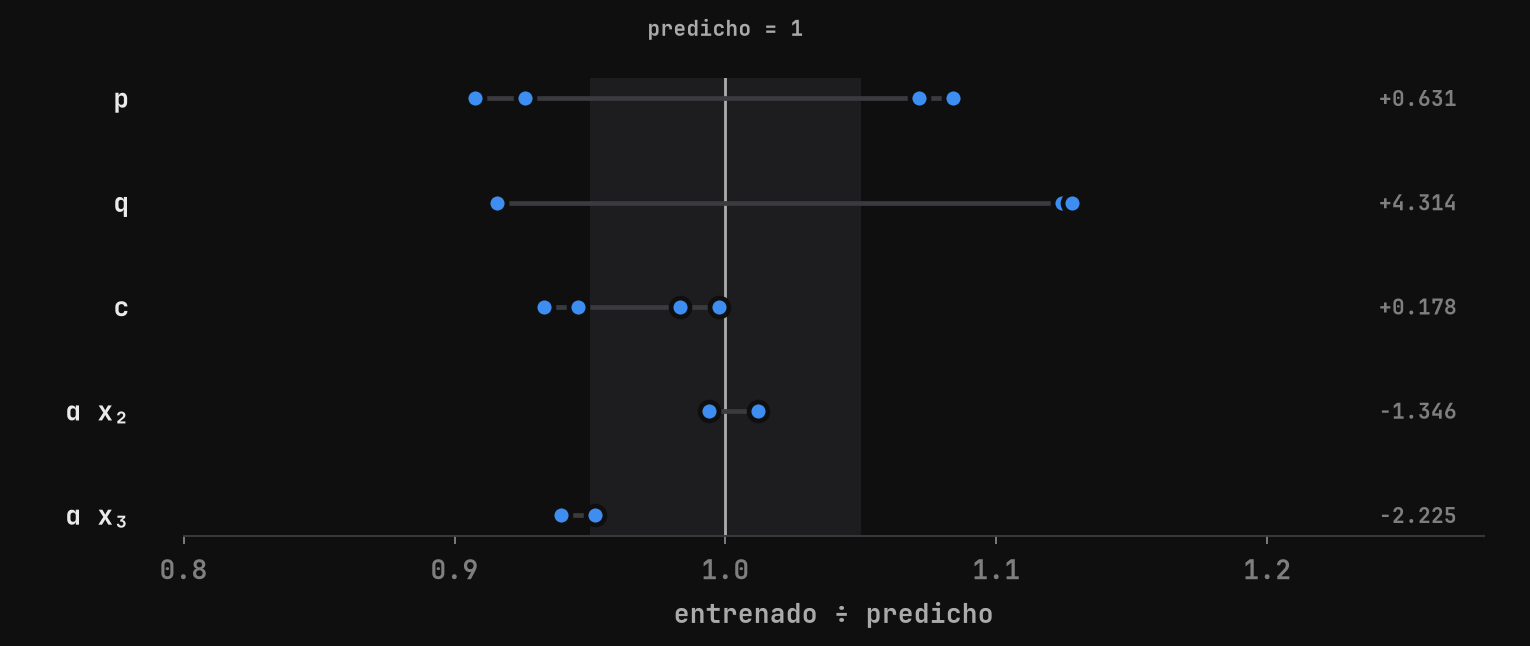
El gemelo de antes se apoyaba en los pesos de la red, entonces teniamos que hacer una red solo con la explicacion. Para ello escribimos las condiciones, que la comparacion fues exacta, que la memoria guardase lo justo y necesario para reconstruir el numero anterior y que la salida tenia que aplicar la regla de la mediana. Al resolverla nos dimos cuenta que todos los pesos habian quedado fijados menos el tamaño de la memoria y cuanto olvida. Y es aqui cuando nos topamos con una sorpresa y es que leyendo el tamaño de la memoria y cuanto olvida de la red entrenada, las formulas predecian el resto de sus pesos. Uno de ellos -1,346 deducido frente a -1,350 entrenado. La red fabricada asi acertaba el 98,52% mientras que la original un 98,455%.
De lo que llevamos ahora me sorprende lo compleja que puede ser una red de tan pocos parametros y ni me imagino meterme dentro de las que tienen miles de millones, como con tan solo 32 la red es capaz de separar comparacion y memoria y que la explicacion sea capaz de preedecir sus propios pesos. Las 150 zonas hasta lograr el 100% no son realmente algo de lo que se pueda sacar nada o entender, son meros calculos que no vale la pena pararse a entender. Con todo esto sabemos que el error de la red fabricada sigue una ley exacta con una memoria mas pequeña aun la red acertaria el 99,999% de las veces, y el porque el entrenamiento se quedo con una memoria mucho mayor sigue sin darnos una respuesta clara. En el proximo post veremos esa ley del error, un recap de todo el proceso y mas hallazgos que sorprenden.
Claude Code escribio el codigo y un resumen de los resultados del que parti, el texto es mio y traducido con DeepL. https://github.com/Xabilimon1/leeuwenhoek
¿Encontraste algo mal? Escríbeme y lo arreglo.
Discussion
Sign in with GitHub to leave a comment. Comments are stored in GitHub Discussions.